Retrieval Augmented Generation: Wie KI aus deinen Dokumenten antwortet
Retrieval Augmented Generation (RAG) einfach erklärt: wie KI aus deinen Dokumenten antwortet, was Studien über Grenzen zeigen und wann es sich lohnt.
 Felix SchmitzKI & Automation · · 8 Min.
Kurz gesagt
- Retrieval Augmented Generation (RAG) lässt ein Sprachmodell vor dem Antworten passende Stellen aus deinen Dokumenten suchen und die Antwort darauf stützen.
- Ein RAG-System ist nur so gut wie die Dokumente dahinter: Eine Studie mit lokalen Modellen fand, dass RAG empfindlich auf uneinheitliche Begriffe in den Quellen reagiert.
- Relevant wirkende Treffer reichen bei mehrstufigen Fragen oft nicht, weil Zwischenschritte fehlen oder das Modell die gefundenen Belege nicht richtig nutzt.
- Wer Dokumente in ein RAG-System einschleusen kann, kann die Antworten steuern, deshalb gehören nur geprüfte Quellen hinein.
- Für kleine Teams reicht oft ein Projektordner im KI-Werkzeug, RAG lohnt sich erst bei vielen, sich ändernden Dokumenten oder vielen Nutzern.
Inhalt8 Abschnitte
- Was Retrieval Augmented Generation ist, einfach erklärt
- RAG, Fine-Tuning oder einfach ein Projektordner
- Ein Praxisbeispiel: Fehlermeldungen mit Firmenwissen beantworten
- Warum gute Dokumente wichtiger sind als das größte Modell
- Relevant ist nicht dasselbe wie vollständig
- Die Schattenseite: Wer deine Dokumente füttert, steuert die Antwort
- Retrieval Augmented Generation im kleinen Unternehmen einführen
- Fazit
Retrieval Augmented Generation, kurz RAG, ist ein Verfahren, bei dem ein Sprachmodell vor dem Antworten passende Textstellen aus einer eigenen Dokumentensammlung sucht und seine Antwort auf diese Stellen stützt. So kann eine KI mit internem oder aktuellem Wissen antworten, das sie im Training nie gesehen hat, und ihre Quellen nennen. Ob die Antworten stimmen, hängt vor allem von der Qualität der Dokumente und der Suche ab.
Die Frage nach RAG kommt bei mir fast immer dann, wenn jemand sagt: „Ich will einen Chatbot, der meine Unterlagen kennt.“ Das klingt nach einem großen Technikprojekt. Oft ist es kleiner, manchmal ist es gar nicht nötig. Und wenn es nötig ist, scheitert es selten am Modell.
Im Artikel zum KI-Wissensmanagement ging es um die organisatorische Seite: Wie kommt Wissen überhaupt in eine pflegbare Form. Hier geht es um die Technik, die darauf aufsetzt. Ich habe dafür aktuelle Forschung zu RAG gelesen. Ein Hinweis vorab: Das Feld ist jung und sehr technisch. Alle vier Studien, die ich hier nutze, sind Konferenzbeiträge, keine Zeitschriftenartikel. Ich lese sie deshalb als Hinweise, gesicherte Regeln sind es noch nicht.
Was Retrieval Augmented Generation ist, einfach erklärt
Das beste Bild für RAG ist eine Prüfung mit offenem Buch. Ein normales Sprachmodell antwortet aus dem Gedächtnis, also aus dem, was es im Training gelernt hat. Mit RAG darf es vor jeder Antwort im Buch nachschlagen. Das Buch sind deine Dokumente.
Technisch läuft das in fünf Schritten ab:
- Zerlegen. Deine Dokumente werden in kurze Abschnitte geteilt, sogenannte Chunks. Ein Chunk ist oft ein Absatz oder eine halbe Seite.
- Indexieren. Jeder Abschnitt wird in eine Zahlenreihe übersetzt, ein sogenanntes Embedding. Ähnliche Inhalte bekommen ähnliche Zahlenreihen. Daneben kann zusätzlich eine klassische Stichwortsuche laufen.
- Suchen. Kommt eine Frage, wird sie ebenfalls übersetzt. Das System sucht die Abschnitte, die der Frage am ähnlichsten sind.
- Anreichern. Die gefundenen Abschnitte werden zusammen mit der Frage an das Sprachmodell gegeben.
- Antworten. Das Modell formuliert eine Antwort auf Grundlage dieser Abschnitte und kann angeben, woher sie stammen.
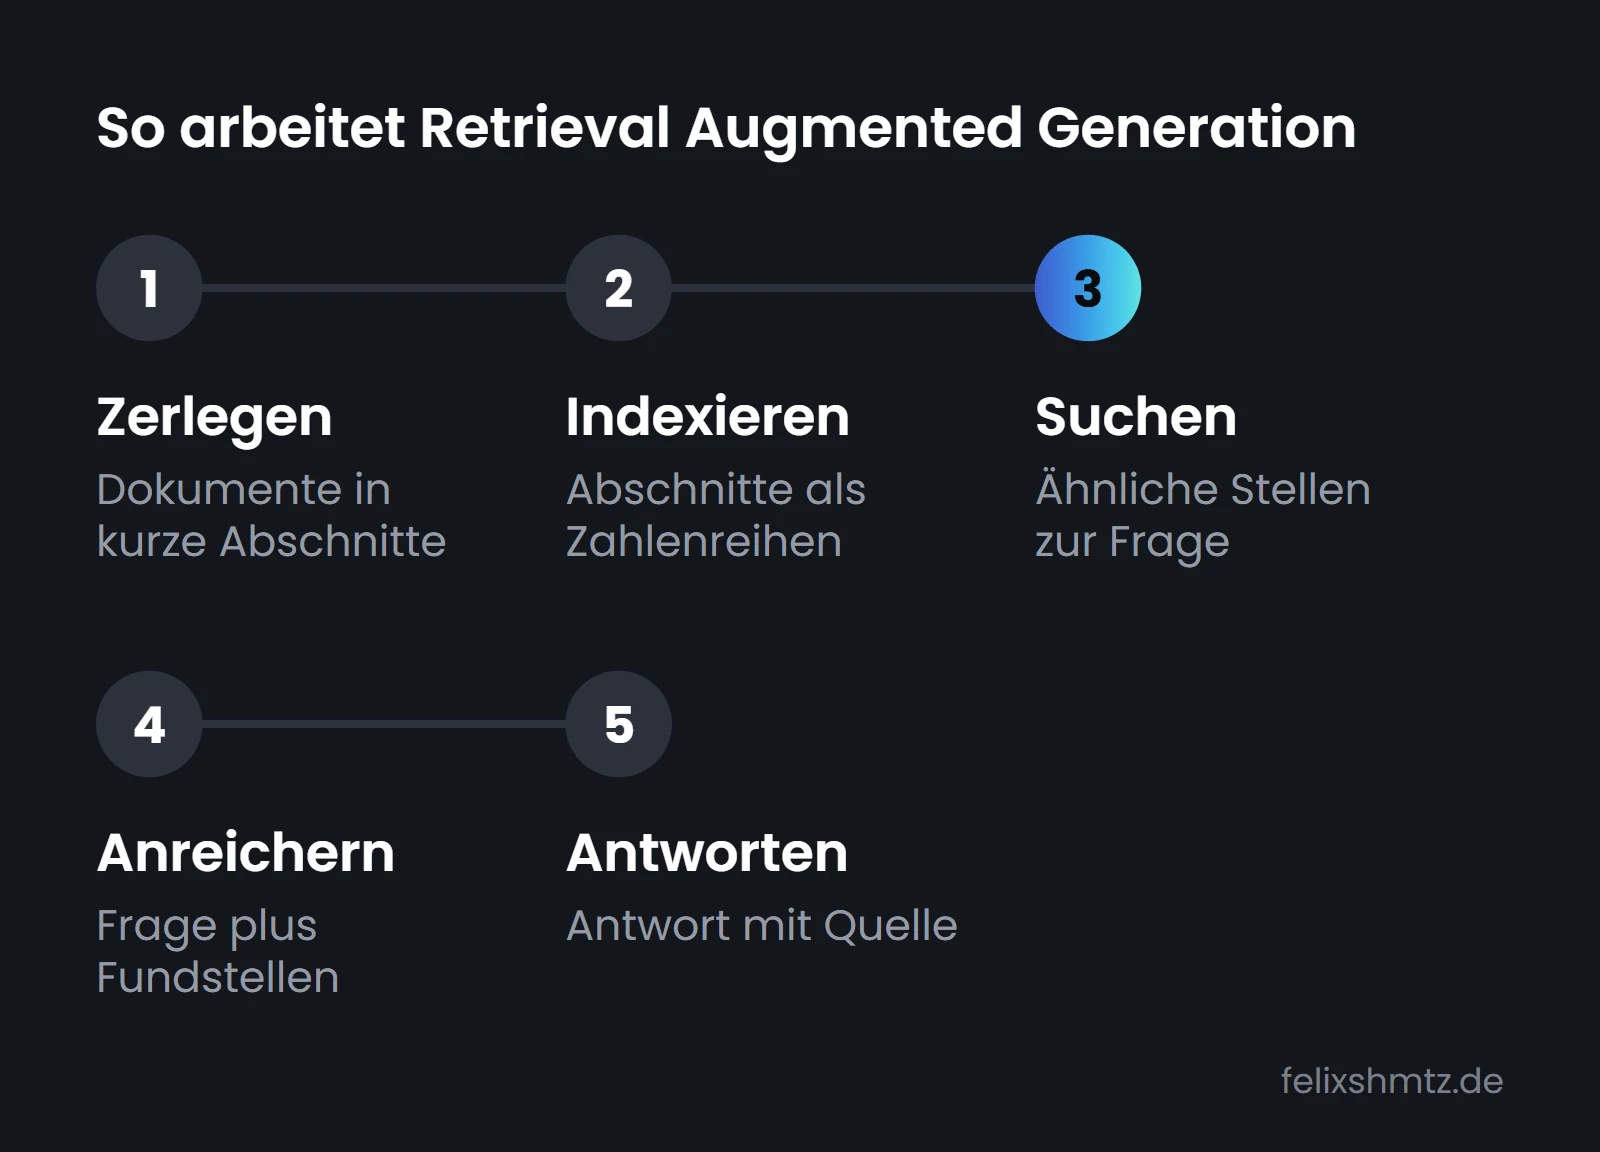
Zerlegen Dokumente werden in Abschnitte geteilt, oft einen Absatz oder eine halbe Seite lang. Wie gut das gelingt, beeinflusst später die Treffer.
Indexieren Jeder Abschnitt wird als Embedding gespeichert, eine Zahlenreihe, die Bedeutung abbildet. Oft läuft daneben eine Stichwortsuche.
Suchen Die Frage wird ebenfalls übersetzt. Das System holt die Abschnitte, die ihr am ähnlichsten sind.
Anreichern Die gefundenen Abschnitte werden zusammen mit der Frage an das Sprachmodell gegeben.
Antworten Das Modell formuliert die Antwort auf Grundlage der Fundstellen und nennt im besten Fall, woher sie stammt.
Der dritte Schritt ist der heikle. Was die Suche nicht findet, sieht das Modell nicht. Und was die Suche falsch findet, verarbeitet das Modell trotzdem.
Der Nutzen von RAG liegt in zwei Dingen. Erstens kennt ein Sprachmodell dein internes Wissen nicht: deine Preise, deine Abläufe, die Absprachen mit einem bestimmten Kunden. Ohne Nachschlagen würde es die Lücke mit plausiblen Annahmen füllen. Mit RAG bekommt es die passenden Stellen mitgeliefert. Zweitens kann eine RAG-Antwort zeigen, auf welche Stelle sie sich stützt. Du kannst also nachprüfen, statt zu glauben.
Beides senkt das Risiko erfundener Antworten, beseitigt es aber nicht. Warum Sprachmodelle überhaupt Dinge erfinden, erkläre ich im Artikel über KI-Halluzinationen. Für alles Weitere hilft es, ein RAG-System gedanklich in zwei Teile zu zerlegen: die Suche und die Antwort. Die meisten Probleme, die ich in den Studien gefunden habe, sitzen in der Suche oder im Zusammenspiel der beiden.
RAG, Fine-Tuning oder einfach ein Projektordner
Bevor du über RAG nachdenkst, lohnt ein Blick auf die Alternativen. Es gibt grob drei Wege, einer KI dein Wissen mitzugeben.
Beim Fine-Tuning wird das Modell selbst mit zusätzlichen Beispielen weitertrainiert. Das verändert vor allem, wie es schreibt und sich verhält. Für Fakten, die sich jeden Monat ändern, ist das unpraktisch, weil du jedes Mal neu trainieren müsstest.
Beim Projektordner lädst du deine Dokumente direkt in ein KI-Werkzeug hoch, und das Werkzeug gibt sie dem Modell bei jeder Frage mit. Viele Chat-Werkzeuge bieten so etwas an. Für eine überschaubare Sammlung reicht das völlig. Angenommen, ein Coach hat ein Angebotsdokument, einen Ablauf für das Erstgespräch und eine Liste häufiger Fragen. Diese drei Dateien in einem Projektordner decken den Großteil seines Alltags ab, ganz ohne eigene Suche.
RAG wird interessant, wenn die Sammlung zu groß wird, um sie bei jeder Frage komplett mitzugeben, wenn sie sich oft ändert oder wenn viele Menschen gleichzeitig Fragen stellen, etwa Kunden über einen Chatbot.
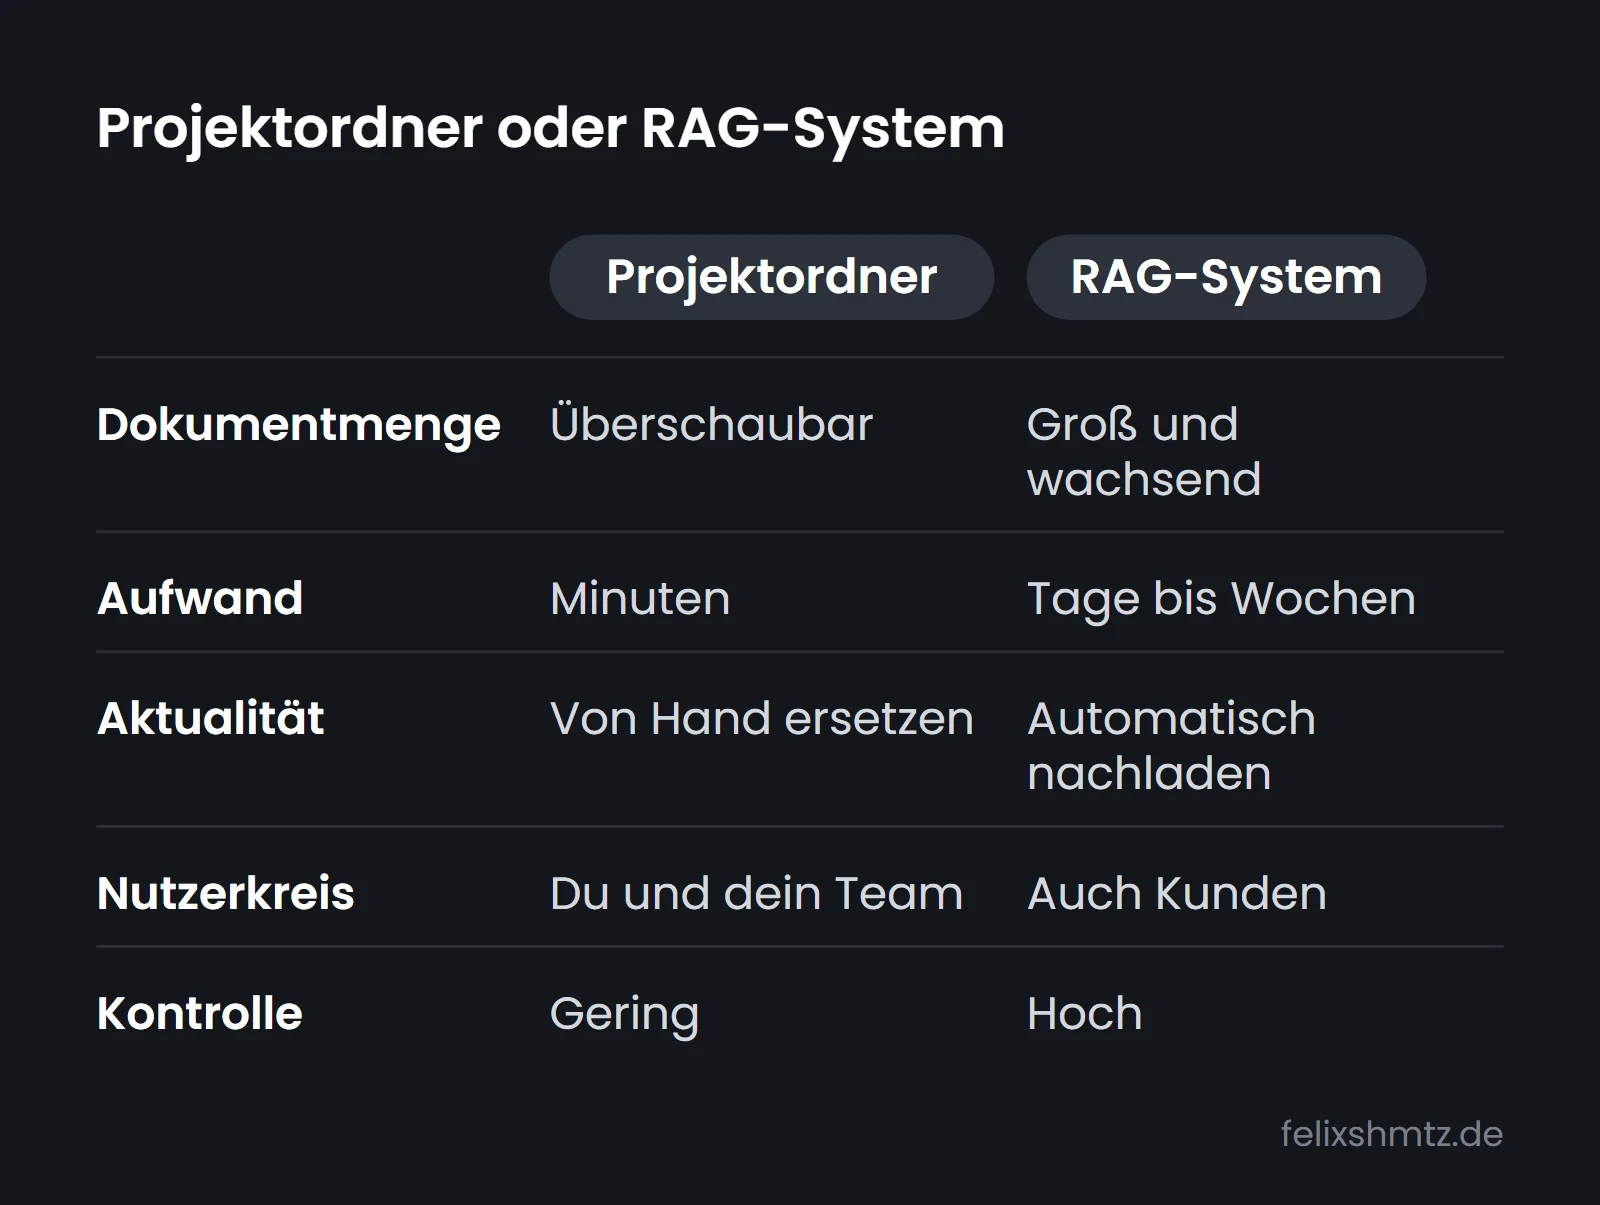
Dokumentmenge Ein Projektordner gibt dem Modell die Dokumente oft vollständig mit. Bei großen Sammlungen braucht es eine Suche, die vorher auswählt.
Aufwand Hochladen geht sofort. Ein eigenes RAG-System braucht Aufbau, Tests und Pflege.
Aktualität Bei RAG lassen sich neue Dokumente laufend in den Index aufnehmen.
Nutzerkreis Sollen Kunden über einen Chatbot Fragen stellen, brauchst du eine eigene Lösung mit klaren Grenzen.
Kontrolle Bei RAG bestimmst du selbst, wie zerlegt und gesucht wird, und kannst Fundstellen anzeigen.
Ein Praxisbeispiel: Fehlermeldungen mit Firmenwissen beantworten
Das anschaulichste Beispiel in meiner Auswahl kommt aus dem IT-Betrieb. Isik, Dogan, Demir und Kollegen (2026) beschreiben in einem Konferenzbeitrag eine RAG-Plattform für SAP-Systeme. Diese Systeme verschicken Fehler- und Warnmeldungen per E-Mail. Die Meldungen sind halb strukturierter Text, schwer von Hand zu prüfen, und vorhandenes Wissen zur Fehlerbehebung wird kaum wiederverwendet.
Die Plattform läuft auf eigenen Servern. Sie liest eingehende Meldungen, bringt sie in ein einheitliches Format und gleicht sie mit früheren Lösungen und technischer Dokumentation ab. Das Sprachmodell erzeugt daraus einen Lösungsvorschlag. Das Team bekommt den Vorschlag zusammen mit den Fundstellen und einer Möglichkeit, Rückmeldung zu geben.
Eine erste Auswertung mit 217 echten Meldungen deutet laut Abstract darauf hin, dass die Plattform die erste Einordnung und die Suche nach passender Dokumentation deutlich verkürzen kann. Die Autoren sind dabei vorsichtig. Ob sich auch die gesamte Zeit bis zur Fehlerbehebung verkürzt, müssten größere Datensätze, Bewertungen durch Fachleute und kontrollierte Vergleiche erst zeigen.
Mir gefällt an dem Beispiel vor allem das Muster, die SAP-Technik ist Nebensache. Wiederkehrende Anfragen kommen per E-Mail, es gibt eine Sammlung früherer Lösungen, und ein Mensch entscheidet am Ende mit Blick auf die Quelle. Dieses Muster passt auch auf ein Support-Postfach einer kleinen Softwarefirma oder auf die häufigsten Fragen an eine Steuerkanzlei.
Warum gute Dokumente wichtiger sind als das größte Modell
Sustek, Javurek, Janok und Kollegen (2026) haben getestet, wie gut sich zwei Sprachmodelle mit RAG auf eigener Hardware betreiben lassen. Sie haben die Modelle Gemma3:27B und Gemma4:31B auf drei Hardware-Konfigurationen mit slowakischen Fragen geprüft.
Das größere Modell antwortete sachlich genauer, besonders bei Aufgaben mit mehreren Schritten. Die Geschwindigkeit hing vor allem an der Rechenleistung und der Speicherbandbreite der Grafikkarte. War deren Speicher zu knapp, wurden Teile des Modells ausgelagert, und alles wurde deutlich langsamer.
Den für mich wichtigsten Satz liefern die Autoren am Rand. RAG reagierte empfindlich darauf, wie die Fragen formuliert waren und ob die Begriffe in den Quelldokumenten einheitlich verwendet wurden. Heißt in einem Dokument etwas „Starterpaket“ und im nächsten „Basistarif“, leidet die Antwort.
Daraus ziehe ich zwei Lehren. Erstens: Bevor du ein größeres Modell kaufst, räum deine Begriffe auf. Das kostet nichts. Zweitens: Wer aus Datenschutzgründen ein Modell lokal betreiben will, braucht passende Hardware, sonst wird es zäh. Was offene Modelle dafür leisten, beschreibe ich im Artikel über Open-Source-LLMs.
Relevant ist nicht dasselbe wie vollständig
Eine Studie hat mir eine Schwäche gezeigt, die ich unterschätzt hatte. Xu und Asadinia (2026) untersuchen Fragen, deren Antwort mehrere Schritte braucht. Ihr Befund: Ein Suchsystem findet oft Stellen, die zur Frage passen, übersieht aber Zwischenschritte, die für eine begründete Antwort nötig sind.
Die Autoren haben dafür eigene Testsammlungen mit geprüften Lösungswegen und gezielt eingebauten Ablenkungen gebaut. Bei knappem Suchbudget fand eine klassische Stichwortsuche oft nur einen Teil der nötigen Belege. Eine Suche, die Abhängigkeiten zwischen Regeln kennt, schloss diese Lücke, sofern die Abhängigkeiten ausdrücklich vorlagen. Bei großzügigem Budget lag der vollständige Lösungsweg oft im Ergebnis, zusammen mit Ablenkungen. Trotzdem nutzten die Modelle die Belege nicht immer richtig, verweigerten zu oft eine Antwort oder brachen wegen zu langer Ausgaben ab.
Das Fazit der Autoren: Eine vollständige Suche ist nötig, aber nicht ausreichend. Das Modell muss die Belege auch richtig verwenden.
Ein Beispiel, wie das im Alltag aussieht. Angenommen, ein Kunde fragt einen Chatbot: „Welche Kündigungsfrist gilt für mich, wenn ich das Paket B vor 2025 gebucht habe?“ Die Antwort braucht drei Stellen: die heutige Frist, die Übergangsregel für Altverträge und die Zuordnung von Paket B. Findet die Suche nur die erste, klingt die Antwort richtig und ist es nicht. Solche mehrstufigen Fragen gehören deshalb in jeden Test.
Die Schattenseite: Wer deine Dokumente füttert, steuert die Antwort
Kafi und Khalil (2026) zeigen in einem weiteren Konferenzbeitrag, wie angreifbar RAG sein kann. Ihr Angriffsverfahren schleust gezielt Dokumente in die Wissenssammlung ein. Es erkennt zuerst, welche echten Quellen das System zu einer Frage findet. Dann erzeugt es Gegendokumente, die genau diese Quellen namentlich abwerten und dabei ausnutzen, dass Modelle neuere und scheinbar autoritative Texte bevorzugen. So lenkt es die Antwort auf ein gewünschtes Ergebnis. Laut Abstract war das Verfahren deutlich wirksamer als bisherige, starre Angriffe.
Die Autoren sehen darin eine grundsätzliche Spannung. Die Transparenz von RAG, also das Offenlegen von Quellen, macht das System nachvollziehbar und zugleich angreifbar.
Für ein kleines Unternehmen ist ein gezielter Angriff eher unwahrscheinlich. Das Prinzip gilt trotzdem. Alles, was in deine Sammlung gelangt, kann die Antworten verändern. Wenn dein Chatbot also Kundenuploads, Bewertungen oder fremde Webseiten mitliest, nimmt er auch deren Fehler und Absichten mit. Ich würde in eine RAG-Sammlung nur geprüfte, eigene Dokumente aufnehmen. Was zusätzlich beim Umgang mit Kundendaten gilt, steht im Artikel zum KI-Datenschutz.
Ein RAG-System antwortet nie besser als der schlechteste Absatz, den es findet.
Retrieval Augmented Generation im kleinen Unternehmen einführen
So würde ich vorgehen, wenn ein Kunde mit dem Wunsch nach einem Chatbot auf eigenen Unterlagen zu mir käme:
- Ohne RAG starten. Lade die wichtigsten Dokumente in den Projektordner eines KI-Werkzeugs und arbeite zwei Wochen damit. Oft reicht das schon.
- Begriffe vereinheitlichen. Eine Bezeichnung pro Produkt, pro Paket, pro Ablauf. Das hilft jedem System und kostet nur einen Nachmittag.
- Testfragen sammeln. Schreib 20 echte Fragen mit der richtigen Antwort und der Fundstelle auf, darunter einige mehrstufige. Damit misst du jede Änderung.
- Quellen anzeigen. Jede Antwort zeigt, woher sie stammt, so wie die Lösungsvorschläge in der SAP-Studie. Das schützt vor stillen Fehlern.
- Erst dann bauen. Reicht der Projektordner nicht mehr, weil die Sammlung zu groß wird oder Kunden zugreifen sollen, lohnt sich ein eigenes System.
Wann ein Chatbot gegenüber Kunden überhaupt sinnvoll ist, habe ich im Artikel über den Chatbot im Kundenservice aufgeschrieben. Und wie viel sich heute ohne Entwicklerteam bauen lässt, beschreibe ich im Artikel zu Claude Code für Gründer.
Bei ai-website.com nutzen wir eine einfache Form derselben Idee. Jedes Website-Paket enthält Projektwissen und Designregeln als Dateien, die ein KI-Werkzeug wie Claude Code beim Arbeiten liest. Das ist noch kein RAG im technischen Sinn. Es folgt aber demselben Gedanken: Die KI soll aus dem Wissen des Projekts arbeiten, statt zu raten.
Fazit
Retrieval Augmented Generation ist eine gute Idee mit einer unbequemen Wahrheit. Das Verfahren lässt eine KI aus deinen Dokumenten antworten, macht die Dokumente aber nicht besser. Die Studien zeigen das von mehreren Seiten: Uneinheitliche Begriffe verschlechtern die Antworten, relevante Treffer sind nicht automatisch vollständig, und wer Dokumente einschleust, kann das Ergebnis lenken. Die Forschung dazu ist jung und stammt fast nur aus Konferenzbeiträgen, die Richtung ist trotzdem eindeutig.
Mein Vorschlag für diese Woche: Schreib 20 Fragen auf, die dir Kunden wirklich stellen, mit der richtigen Antwort daneben. Lade deine Unterlagen in den Projektordner eines KI-Werkzeugs und prüf, wie viele der 20 Antworten stimmen. Das Ergebnis sagt dir, ob du ein RAG-System brauchst oder erst bessere Dokumente. Was ich bei meinen eigenen Builds dazu lerne, teile ich in den Unternehmer Thoughts.
Mit KI weiterdenken
Frag deine KI zu diesem Artikel
Öffnet den Dienst in einem neuen Tab. Erst mit dem Klick geht der Prompt an den Anbieter, vorher wird nichts übertragen.
Häufige Fragen
Was ist Retrieval Augmented Generation einfach erklärt?
RAG ist wie eine Prüfung mit offenem Buch. Bevor die KI antwortet, sucht sie in deinen Dokumenten nach passenden Stellen und formuliert die Antwort auf dieser Grundlage. So kann sie aktuelles und internes Wissen nutzen und ihre Quellen nennen.
Was ist der Unterschied zwischen RAG und Fine-Tuning?
Beim Fine-Tuning wird das Modell selbst mit zusätzlichen Beispielen weitertrainiert, was vor allem Stil und Verhalten verändert. Bei RAG bleibt das Modell unverändert und bekommt bei jeder Frage passende Textstellen mitgeliefert. Für Wissen, das sich oft ändert, ist RAG meist die einfachere Wahl.
Verhindert RAG Halluzinationen?
RAG verringert das Risiko, weil die KI sich auf konkrete Textstellen stützt, schließt Fehler aber nicht aus. Findet das System unvollständige oder widersprüchliche Stellen oder nutzt das Modell sie falsch, entstehen weiterhin falsche Antworten. Deshalb sollte jede Antwort ihre Quelle zeigen.
Brauche ich als kleines Unternehmen ein eigenes RAG-System?
Meist nicht am Anfang. Viele KI-Werkzeuge erlauben es, Dokumente in einem Projekt hochzuladen, und das reicht für eine überschaubare Sammlung. Ein eigenes System lohnt sich, wenn du viele Dokumente hast, sie sich oft ändern oder Kunden über einen Chatbot darauf zugreifen sollen.
Quellen4 Quellen
- Isik, Dogan, Demir et al. (2026): Automated Processing of SAP Solution Manager Error Notifications Using Large Language Models: A RAG-Based Platform. International Artificial Intelligence and Data Processing Symposium (IDAP) (öffnet in neuem Tab)
- Sustek, Javurek, Janok et al. (2026): Comparison of On-Premises Large Language Models using Retrieval-Augmented Generation in Academic and Military Environments. New Trends in Signal Processing (NTSP) (öffnet in neuem Tab)
- Xu, Asadinia (2026): When Relevance Is Not Enough: Minimal Support Recovery for Faithful RAG Reasoning. International Conference on Machine Learning and Applications (ICMLA) (öffnet in neuem Tab)
- Kafi, Khalil (2026): RAG-Narok: Retrieval-Aware Knowledge Corpus Poisoning in RAG with Source-specific Refutation. International Conference on Machine Learning and Applications (ICMLA) (öffnet in neuem Tab)
Woran ich baue
- Boutique für digitales WachstumquikWebsites, Sichtbarkeit und Messung als ein System
- Marktplatz und Studio für AI Website Templatesai-website.comWebsites, die deine KI weiterbaut
- KI-fähiger Workspace aus Deutschlandquik OSEin Workspace, in dem KI-Assistenten mitarbeiten
Erstgespräch mit mir buchenUnternehmer Thoughts lesenAlle Projekte