KI-Datenschutz: Wie du KI nutzt, ohne den Datenschutz zu riskieren
KI-Datenschutz für Selbstständige: was Studien über KI-Vorfälle und Nutzersorgen zeigen und welche Regeln du für Kundendaten in KI-Tools brauchst.
 Felix SchmitzKI & Automation · · 8 Min.
Kurz gesagt
- KI-Datenschutz heißt, personenbezogene und vertrauliche Daten auch beim Eingeben in KI-Werkzeuge, bei der Speicherung durch den Anbieter und bei der Ausgabe zu schützen.
- Eine Analyse von 202 realen KI-Vorfällen zeigt, dass viele Schäden aus schlechten Entscheidungen in Organisationen und aus Rechtsverstößen entstehen und selten gemeldet werden.
- Befragungen zeigen ein Datenschutz-Paradox: Viele Menschen misstrauen KI beim Umgang mit ihren Daten und nutzen sie trotzdem.
- Weil Kunden selten Grenzen ziehen, liegt die Verantwortung bei dem Unternehmen, das KI einsetzt.
- Für kleine Teams reichen sechs Regeln: Daten einteilen, Werkzeug prüfen, Daten sparen, Zugriffe begrenzen, offen informieren und einen Plan für Pannen haben.
Inhalt8 Abschnitte
- Was KI-Datenschutz für kleine Unternehmen bedeutet
- Was 202 reale KI-Vorfälle zeigen
- Das Datenschutz-Paradox: Sorge und Nutzung zugleich
- Warum wir unser eigenes Risiko unterschätzen
- Welche Daten in welches KI-Werkzeug dürfen
- KI-Datenschutz in sechs Regeln
- Wie ich KI-Datenschutz bei meinen Projekten angehe
- Fazit
KI-Datenschutz bedeutet, personenbezogene und vertrauliche Daten auch dann zu schützen, wenn du KI-Werkzeuge nutzt: beim Eingeben, bei der Speicherung durch den Anbieter und bei der Ausgabe an Dritte. Für kleine Unternehmen heißt das vor allem, zu wissen, welche Daten in welches Werkzeug dürfen, Verträge und Einstellungen zu prüfen und Kunden offen zu sagen, wo KI im Spiel ist. Die meisten Risiken entstehen durch ganz alltägliche Entscheidungen im eigenen Team.
Das Thema ist mir wichtig, weil KI-Werkzeuge in kleinen Teams oft ohne jede Regel einziehen. Jemand kopiert eine Kundenmail in einen Chat, lässt eine Antwort formulieren und denkt nicht weiter darüber nach. Das ist bequem. Es bedeutet aber auch, dass Daten deiner Kunden bei einem Anbieter landen, den du nie geprüft hast.
Zur Einordnung vorab: Ich bin kein Jurist, und dieser Artikel ersetzt keine Rechtsberatung. Mir geht es um die Praxis. Wie du Einwilligungen im Marketing sauber einholst, steht im Artikel zu DSGVO im Marketing. Hier geht es um den Alltag mit KI-Werkzeugen.
Was KI-Datenschutz für kleine Unternehmen bedeutet
Bei KI gibt es drei Momente, in denen Daten in Gefahr geraten können.
- Bei der Eingabe. Alles, was du in einen Prompt kopierst, verlässt dein System. Eine Kundenmail mit Name, Adresse und Vertragsdetails ist ein Datensatz, auch wenn sie sich wie eine harmlose Textaufgabe anfühlt.
- Beim Anbieter. Je nach Werkzeug und Tarif werden Eingaben gespeichert, von Menschen geprüft oder zum Training genutzt. Wo die Server stehen und welcher Vertrag gilt, entscheidet, ob du das überhaupt darfst.
- Bei der Ausgabe. Ein Chatbot auf deiner Website kann Informationen an Dritte weitergeben, die er nicht weitergeben sollte. Eine KI mit Zugriff auf deine Ablage findet auch Dokumente, die nicht für alle gedacht sind.
Die DSGVO gilt dabei wie bei jeder anderen Datenverarbeitung. Du brauchst eine Rechtsgrundlage, solltest nur so viele Daten nutzen wie nötig und musst transparent machen, was passiert. Verarbeitet ein Anbieter Daten in deinem Auftrag, brauchst du in der Regel einen Vertrag zur Auftragsverarbeitung. Bei kostenlosen Verbraucherversionen von KI-Werkzeugen fehlt dieser meist.
Neu ist der EU AI Act. Er verlangt unter anderem, dass Menschen erkennen können, wenn sie mit einer KI sprechen. Was das Gesetz für kleine Unternehmen bedeutet, beschreibe ich im Artikel zum EU AI Act.
Was 202 reale KI-Vorfälle zeigen
Die aufschlussreichste Studie in meiner Auswahl kommt von Hadan, Hadi Mogavi, Zhang-Kennedy und Nacke (2026). Sie haben im International Journal of Human-Computer Interaction 202 reale Vorfälle rund um Datenschutz und Ethik bei KI ausgewertet. Daraus haben sie ein Ordnungssystem entwickelt, das Vorfälle nach Phase im Lebenszyklus einer KI einordnet und Ursachen, Verantwortliche, Art der Aufdeckung und Folgen erfasst.
Drei Ergebnisse finde ich für kleine Unternehmen besonders wichtig:
- Viele Schäden entstehen durch schlechte Entscheidungen in Organisationen und durch Verstöße gegen geltendes Recht.
- Wirksame Gegenmaßnahmen nach einem Vorfall sind selten.
- Die Entwickler von KI und die Unternehmen, die KI einsetzen, melden Vorfälle selbst nur selten.
Der erste Punkt verschiebt den Blick. Wir denken bei Datenschutz gern an Angriffe von außen. Die Studie legt nahe, dass ein großer Teil des Problems in Entscheidungen von innen liegt. Wer welches Werkzeug wofür einsetzt, wer Zugriff bekommt und ob jemand die Regeln kennt, sind genau solche Entscheidungen.
Die Studie betrachtet große, öffentlich bekannte Vorfälle, und die Autoren heben besonders Bereiche wie soziale Medien und Kinderschutz hervor. Ein Solo-Selbstständiger taucht in solchen Datenbanken kaum auf. Das Muster lässt sich trotzdem übertragen. Wer KI einsetzt, ist für die Folgen mitverantwortlich, auch wenn er die KI nicht gebaut hat.
Ein Beispiel, wie klein so eine Entscheidung sein kann. Angenommen, ein Fitnessstudio lässt Kündigungsmails von einer KI vorsortieren und gibt ihr dafür Zugriff auf das komplette Mitgliederpostfach. Niemand hat entschieden, dass die KI auch Krankmeldungen mit Attest lesen soll. Es ist einfach so passiert, weil der Zugriff zu weit gefasst war. Genau solche organisatorischen Lücken beschreibt die Studie.
Das Datenschutz-Paradox: Sorge und Nutzung zugleich
Zwei Befragungen zeigen, wie widersprüchlich Menschen mit KI und ihren Daten umgehen. Beide sind Konferenzbeiträge, ich lese sie deshalb als Stimmungsbild.
Olatunde und Mohamed (2025) haben Verhaltensdaten von 656 Teilnehmenden ausgewertet, mit beschreibender Statistik, Vergleichen, Clustern und Korrelationen. Sie beschreiben ein Datenschutz-Paradox: Viele, die KI beim Datenschutz misstrauen, nutzen KI-Werkzeuge trotzdem.
Breiki, Mahmoud, Al-Riyami und Aljneibi (2025) haben 290 Personen zu ihrem Wissen über Datenschutzrisiken, ihrem Vertrauen und ihrem Umgang mit Datenschutzerklärungen befragt. Sie finden eine deutliche Lücke zwischen Nutzung und Bewusstsein. Viele wissen nicht, was mit ihren Daten passiert.
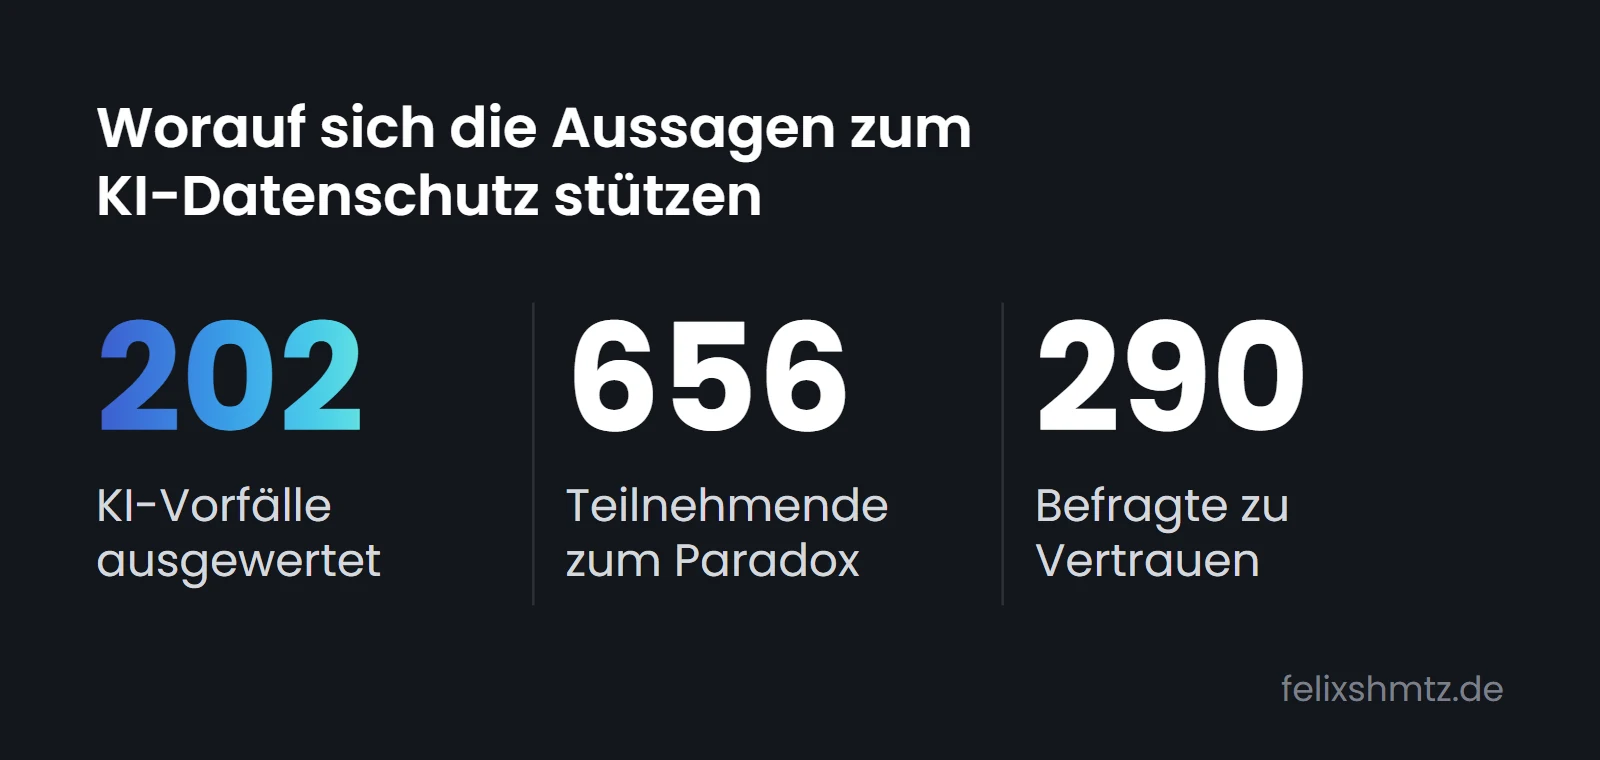
KI-Vorfälle ausgewertet Hadan und Kollegen (2026) ordnen reale Vorfälle nach Ursachen, Verantwortlichen, Aufdeckung und Folgen.
Teilnehmende zum Paradox Olatunde und Mohamed (2025): Viele, die KI beim Datenschutz misstrauen, nutzen sie trotzdem.
Befragte zu Vertrauen Breiki und Kollegen (2025): eine deutliche Lücke zwischen Nutzung von KI und Bewusstsein für Datenschutz.
Für dich als Unternehmer heißt das: Deine Kunden werden dich selten bremsen. Sie fragen nicht nach, welches Werkzeug du nutzt, und schicken dir trotzdem sensible Unterlagen. Gerade deshalb liegt die Verantwortung bei dir. Wer hier sauber arbeitet und das offen sagt, kann sich abheben. Wie Transparenz bei Daten Vertrauen schafft und wo sie an Grenzen stößt, beschreibe ich im Artikel zu Personalisierung und Datenschutz.
Warum wir unser eigenes Risiko unterschätzen
Eine kleine, qualitative Studie gibt dem Paradox einen Namen. Wang, Li und Cong (2025) haben im Journal of Academic Ethics 15 Studierende ausführlich zu ihren Sorgen beim Einsatz generativer KI interviewt. Auf persönlicher Ebene untersuchen sie unter anderem Datenschutzerfahrungen, Fähigkeiten zum Selbstschutz und den sogenannten Optimismus-Bias, also die Neigung zu glauben, dass ein Risiko eher andere trifft als einen selbst. Auf sozialer Ebene geht es um den Einfluss von Gleichaltrigen und darum, wie wirksam Datenschutzerklärungen wahrgenommen werden.
Wie stark diese Faktoren jeweils wirken, beschreibt das Abstract nicht. Das wäre bei 15 Interviews auch nicht seriös. Für mich ist der Begriff trotzdem nützlich, weil ich den Optimismus-Bias bei Gründern ständig sehe. „Bei mir passiert schon nichts, ich bin ja klein.“ Genau dieser Gedanke führt dazu, dass Kundendaten in kostenlosen Werkzeugen landen.
Welche Daten in welches KI-Werkzeug dürfen
Die wichtigste Entscheidung im KI-Datenschutz ist eine Zuordnung: Wie sensibel sind die Daten, und wie viel Kontrolle hast du über das Werkzeug? Kontrolle heißt hier, dass ein passender Vertrag besteht, Training mit deinen Eingaben abgeschaltet ist, du weißt, wo verarbeitet wird, und Zugriffe begrenzt sind.
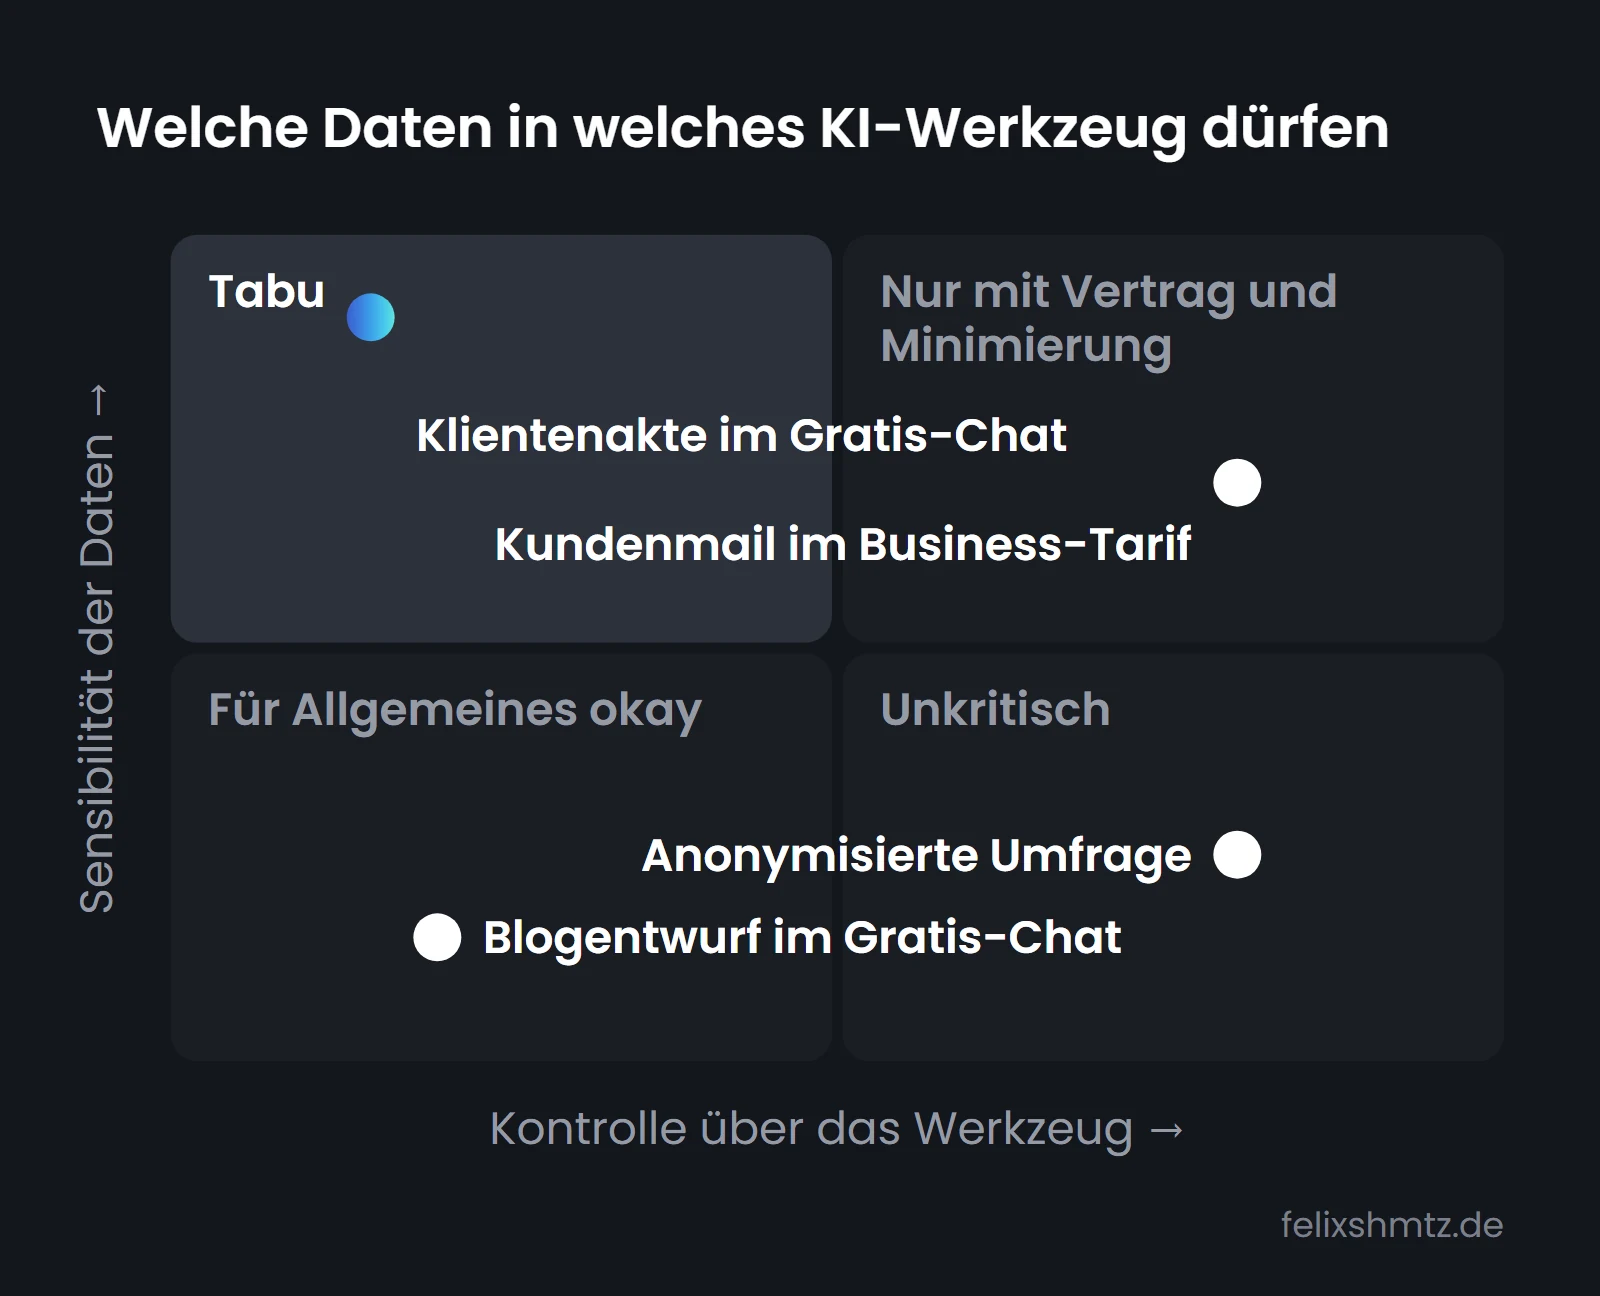
Klientenakte im Gratis-Chat Gesundheits- oder Finanzdaten in einem kostenlosen Werkzeug ohne Vertrag. Das solltest du nie tun.
Kundenmail im Business-Tarif Mit Vertrag zur Auftragsverarbeitung und abgeschaltetem Training vertretbar, besser mit Platzhaltern statt Namen.
Blogentwurf im Gratis-Chat Öffentliche oder allgemeine Inhalte ohne Personenbezug sind auch in einfachen Werkzeugen unproblematisch.
Anonymisierte Umfrage Ohne Personenbezug und in einem geprüften Werkzeug kannst du frei arbeiten.
Das Feld oben links ist das, worum es in der Praxis geht. Hier passieren die meisten Fehler, oft aus reiner Bequemlichkeit. Ein Vertrag mit dem Anbieter ändert daran wenig, wenn trotzdem jemand die Klientenakte in die private App kopiert.
KI-Datenschutz in sechs Regeln
Aus den Studien und meiner eigenen Arbeit ergeben sich sechs Regeln, die ohne Rechtsabteilung funktionieren:
- Daten einteilen. Leg fest, welche Daten bei dir sensibel sind, etwa Gesundheit, Finanzen, Verträge und alles mit Namen. Schreib es auf einer halben Seite auf.
- Werkzeug prüfen. Nutze für Kundendaten nur Werkzeuge mit passendem Vertrag, abgeschaltetem Training und nachvollziehbarem Ort der Verarbeitung. Schau in die Einstellungen, nicht nur ins Marketing des Anbieters.
- Daten sparen. Ersetze Namen und Details durch Platzhalter, bevor du etwas einfügst. Die KI braucht für eine gute Antwort selten den echten Namen.
- Zugriffe begrenzen. Ein KI-Assistent mit Zugriff auf deine Ablage sollte nur die Bereiche sehen, die er braucht. Das gilt besonders, wenn du ein Wissenssystem aufbaust, wie im Artikel zum KI-Wissensmanagement beschrieben.
- Offen informieren. Nenn deine KI-Werkzeuge in den Datenschutzhinweisen, und kennzeichne Chatbots als KI. Wie ein Chatbot gegenüber Kunden gut funktioniert, steht im Artikel über den Chatbot im Kundenservice.
- Einen Pannenplan haben. Leg fest, wer entscheidet, wenn Daten falsch gelandet sind. Bei einer meldepflichtigen Datenpanne hast du nach der DSGVO in der Regel nur 72 Stunden, um die Aufsichtsbehörde zu informieren.
Die sechste Regel ist die, an die fast niemand denkt. Sie hängt direkt mit dem Befund von Hadan und Kollegen zusammen, dass Vorfälle selten gemeldet und selten wirksam behoben werden. Ein Plan auf einer Seite reicht, solange er existiert, bevor etwas passiert.
So sieht Daten sparen im Alltag aus
Regel drei klingt abstrakt, ist im Alltag aber eine Sache von Sekunden. Angenommen, eine Steuerberaterin will eine Antwort an einen Mandanten formulieren lassen. Die Mail lautet im Original: „Herr Berger aus der Lindenstraße 12 fragt, ob er die Kosten für die Pflege seiner Mutter absetzen kann.“
Für die KI reicht eine andere Fassung: „Ein Mandant fragt, ob er Pflegekosten für einen Angehörigen absetzen kann.“ Die Antwort wird genauso gut. Name, Adresse und das Gesundheitsdetail bleiben in der Kanzlei. Den Namen setzt sie erst in ihrem eigenen Mailprogramm wieder ein.
Das funktioniert in den meisten Fällen. Wo es nicht reicht, weil die KI wirklich mit echten Akten arbeiten soll, braucht es ein Werkzeug mit passendem Vertrag oder ein Modell, das auf eigener Hardware läuft. Was solche offenen Modelle leisten und was sie kosten, beschreibe ich im Artikel über Open-Source-LLMs.
Was Kunden davon haben
Datenschutz wirkt oft wie reine Pflicht. Ich sehe darin auch ein Verkaufsargument. Wer einem Kunden in einem Satz erklären kann, welche Werkzeuge er nutzt und welche Daten dort nie landen, wirkt professioneller als jemand, der bei der Frage ins Stocken gerät. Gerade weil die Befragungen zeigen, dass viele Menschen unsicher sind, was mit ihren Daten passiert, ist eine klare Antwort ein Vertrauensvorschuss.
Wie ich KI-Datenschutz bei meinen Projekten angehe
Bei quik OS haben wir uns für einen Workspace aus Deutschland entschieden. KI-Assistenten wie Claude arbeiten darin über einen rechtebasierten MCP-Zugang. Das heißt konkret: Die KI sieht nur, was die Person sehen darf, die sie gerade nutzt. Für mich ist das Regel vier aus der Liste, eingebaut ins Produkt statt in eine Richtlinie, die niemand liest.
Bei quik gilt außerdem, dass dem Kunden am Ende alles gehört. Das betrifft auch seine Daten. Wenn ich für Kunden Automationen mit KI baue, gehört die Frage, welche Daten durch welches Werkzeug laufen, deshalb ganz an den Anfang des Projekts.
Datenschutz bei KI entscheidet sich beim Einfügen, lange bevor ein Anbieter irgendetwas speichert.
Mein persönlicher Test vor jedem Prompt ist einfach. Ich stelle mir vor, der Kunde, um dessen Daten es geht, schaut mir über die Schulter. Wenn mir das unangenehm wäre, ersetze ich die Details durch Platzhalter.
Fazit
KI-Datenschutz ist für kleine Unternehmen vor allem eine Frage von Gewohnheiten. Die Studien zeigen, dass viele Vorfälle aus Entscheidungen in Organisationen entstehen, dass Menschen KI trotz Sorgen nutzen und dass wir unser eigenes Risiko gern unterschätzen. Daraus folgt eine klare Aufgabe: Du legst die Grenzen fest, weil deine Kunden es meistens nicht tun.
Mein Vorschlag für diese Woche: Schreib auf eine halbe Seite, welche Daten bei dir sensibel sind und welche KI-Werkzeuge du dafür nutzen darfst. Prüf dann bei deinem meistgenutzten Werkzeug, ob ein passender Vertrag besteht und das Training mit deinen Eingaben abgeschaltet ist. Was ich dazu bei meinen eigenen Projekten lerne, teile ich in den Unternehmer Thoughts.
Mit KI weiterdenken
Frag deine KI zu diesem Artikel
Öffnet den Dienst in einem neuen Tab. Erst mit dem Klick geht der Prompt an den Anbieter, vorher wird nichts übertragen.
Häufige Fragen
Darf ich Kundendaten in ChatGPT oder andere KI-Tools eingeben?
Personenbezogene Kundendaten solltest du nur in Werkzeuge eingeben, für die eine passende Rechtsgrundlage und in der Regel ein Vertrag zur Auftragsverarbeitung bestehen. Bei kostenlosen Verbraucherversionen ist das meist nicht der Fall. Im Zweifel ersetzt du Namen und Details durch Platzhalter, bevor du etwas einfügst.
Was ist beim Datenschutz mit KI nach DSGVO zu beachten?
Es gelten dieselben Grundsätze wie bei jeder Datenverarbeitung: Rechtsgrundlage, Zweckbindung, Datensparsamkeit, Transparenz und Sicherheit. Bei KI kommen Fragen dazu, ob der Anbieter Eingaben speichert oder zum Training nutzt und wo die Daten verarbeitet werden. Dieser Artikel ersetzt keine Rechtsberatung.
Wie anonymisiere ich Daten für KI-Tools?
Ersetze Namen, Adressen, Kontaktdaten und eindeutige Kennnummern durch Platzhalter wie Kunde A oder Firma B. Achte auch auf Details, über die man eine Person wiedererkennen kann, etwa eine seltene Berufsbezeichnung in Kombination mit dem Wohnort.
Muss ich meine Kunden informieren, wenn ich KI einsetze?
Wenn du personenbezogene Daten mit KI verarbeitest, gehört das in deine Datenschutzhinweise. Sprechen Kunden direkt mit einer KI, etwa mit einem Chatbot, verlangt der EU AI Act zusätzlich, dass sie das erkennen können. Offenheit stärkt außerdem das Vertrauen.
Quellen4 Quellen
- Hadan, Hadi Mogavi, Zhang-Kennedy et al. (2026): Who is Responsible When AI Fails? Mapping Causes, Entities, and Consequences of AI Privacy and Ethical Incidents. International Journal of Human-Computer Interaction (öffnet in neuem Tab)
- Olatunde, Mohamed (2025): Exploring the Privacy Paradox in AI Adoption: A Data-Driven Analysis of User Engagement. International Conference on Artificial Intelligence, Robotics and Control (AIRC) (öffnet in neuem Tab)
- Breiki, Mahmoud, Al-Riyami et al. (2025): Privacy in Generative AI: Understanding User Concerns, Trust, and Awareness. IEEE/ACS International Conference on Computer Systems and Applications (AICCSA) (öffnet in neuem Tab)
- Wang, Li, Cong (2025): University Students' Privacy Concerns towards Generative Artificial Intelligence. Journal of Academic Ethics (öffnet in neuem Tab)
Woran ich baue
- Boutique für digitales WachstumquikWebsites, Sichtbarkeit und Messung als ein System
- Marktplatz und Studio für AI Website Templatesai-website.comWebsites, die deine KI weiterbaut
- KI-fähiger Workspace aus Deutschlandquik OSEin Workspace, in dem KI-Assistenten mitarbeiten
Erstgespräch mit mir buchenUnternehmer Thoughts lesenAlle Projekte