Predictive Analytics im Marketing: Was Vorhersagen kleinen Teams bringen
Predictive-Analytics-Marketing einfach erklärt: was sich vorhersagen lässt, warum simple Modelle oft reichen und wie kleine Teams ohne Datenteam starten.
 Felix SchmitzGrowth Hacking · · 7 Min.
Kurz gesagt
- Predictive Analytics im Marketing sagt pro Kunde voraus, was er als Nächstes tut, etwa wieder kaufen, kündigen oder auf ein Angebot reagieren.
- Eine Vorhersage ist nur so viel wert wie die Entscheidung, die sie verbessert, deshalb steht die Frage vor dem Modell.
- Chou und Kollegen zeigen, dass ein einfaches Modell aus Kaufzeitpunkt und Kaufhäufigkeit die wichtigste Zutat für die Wiederkauf-Prognose war.
- Im Fall des Werbemittelhändlers Geiger fand ein eingebautes Modell unter den 50 gefährdetsten Kunden mehr als doppelt so viele echte Abwanderer wie eine Zufallsauswahl.
- Kleine Teams starten am besten mit einer Frage, einer Tabelle und einer Regel, die sie jede Woche anwenden.
Inhalt7 Abschnitte
Predictive Analytics im Marketing bedeutet, aus vorhandenen Kundendaten vorherzusagen, was einzelne Kunden als Nächstes tun: wieder kaufen, abspringen oder auf ein Angebot reagieren. Der Kern von Predictive-Analytics-Marketing ist also eine Prognose pro Kunde, die eine konkrete Entscheidung besser macht, zum Beispiel wen du anrufst und wem du welches Angebot schickst. Für kleine Teams reicht dafür oft schon ein einfaches Modell aus letztem Kaufdatum und Kaufhäufigkeit.
In meiner Zeit in der Business Intelligence bei Snipes habe ich viel mit Daten gearbeitet, die zurückschauen: Umsätze, Tracking, Berichte. Solche Zahlen erklären, was passiert ist. Spannend wird es für mich dort, wo Daten nach vorn zeigen und eine Entscheidung von morgen verändern.
Das Thema hat aber eine Schattenseite. Kaum ein Feld produziert so viele Studien mit beeindruckenden Trefferquoten, die im Alltag eines kleinen Unternehmens wenig bedeuten. Ich habe für diesen Artikel 14 Fachartikel gesichtet und drei ausgewählt, die mir etwas Brauchbares gezeigt haben: dass einfache Modelle stark sind, dass die Unterschiede zwischen Verfahren oft klein ausfallen und wie ein mittelständisches Unternehmen aus Deutschland eine Vorhersage tatsächlich in den Vertrieb gebracht hat.
Was Predictive Analytics im Marketing vorhersagt
Predictive Analytics ist ein Sammelbegriff. Gemeint sind statistische Verfahren und Machine Learning, die aus vergangenem Verhalten eine Wahrscheinlichkeit für künftiges Verhalten berechnen. Im Marketing geht es fast immer um einzelne Kunden oder Kontakte.
Die wichtigste Regel steht für mich ganz am Anfang: Eine Vorhersage ist nur so viel wert wie die Entscheidung, die sie verbessert. Wer kein klares „Und dann?“ hat, baut ein Modell für die Schublade. Diese Tabelle zeigt die häufigsten Fragen und was du mit der Antwort anfangen kannst:
| Prognosefrage | Was du damit entscheidest | Einfacher Start |
|---|---|---|
| Wer kauft bald wieder? | Wann du dich meldest und mit welchem Angebot | Tage seit dem letzten Kauf im Vergleich zum üblichen Abstand |
| Wer springt ab? | Wen du persönlich ansprichst, bevor er geht | Rückgang der Nutzung oder Bestellungen über mehrere Wochen |
| Wer reagiert auf eine Kampagne? | An wen du eine Aktion schickst | Reaktionen auf frühere Aktionen |
| Wie viel ist ein Kunde wert? | Wie viel Aufwand ein Kunde verdient | Umsatz der letzten zwölf Monate |
| Welcher Kontakt wird Kunde? | Wen du im Vertrieb zuerst anrufst | Herkunft und Verhalten bisheriger Neukunden |
Die rechte Spalte ist meine Vereinfachung. Sie zeigt, dass jede dieser Fragen mit einer Tabelle beginnen kann, lange bevor ein Algorithmus ins Spiel kommt. Wie du Kunden über Kaufzeitpunkt, Häufigkeit und Umsatz in Gruppen einteilst, beschreibe ich ausführlich im Artikel zur RFM-Analyse.
Einfache Modelle sind oft erstaunlich stark
Die Studie, die mir am meisten geholfen hat, stammt von Chou, Chuang, Chou und Liang (2022) im European Journal of Operational Research. Sie vergleichen zwei Denkschulen für die Frage, ob und wie oft ein Kunde wieder kauft.
Die erste Schule sind sogenannte Buy-till-you-die-Modelle aus der Marketingforschung. Sie sind sparsam und arbeiten im Kern nur mit zwei Größen: wann ein Kunde zuletzt aktiv war und wie oft er aktiv war. Die zweite Schule ist Machine Learning, das mit sehr vielen Merkmalen aus den Transaktionen arbeitet.
Mit den Daten eines großen Onlinehändlers haben die Autoren beide Ansätze getestet und anschließend kombiniert. Sie haben die Prognose des einfachen Modells als zusätzliches Merkmal in ein Machine-Learning-Modell gegeben. Das Ergebnis laut Abstract: Die Kombination war deutlich besser als jedes der beiden Modelle allein. Und unter rund 100 möglichen Merkmalen war ausgerechnet die Prognose des einfachen Modells das einflussreichste. Die kombinierte Variante schnitt in Robustheitstests auch besser ab als zwei aufwendige neuronale Netze.
Für mich steckt darin die wichtigste Lektion des ganzen Themas. Zeitpunkt und Häufigkeit des letzten Kaufs tragen einen großen Teil der Information. Mehr Daten können helfen, ersetzen diese Grundlage aber nicht.
Eine zweite Studie bestätigt das Muster von einer anderen Seite. GhorbanTanhaei, Boozary, Sheykhan und Kollegen (2024) vergleichen in Results in Control and Optimization fünf gängige Verfahren zur Vorhersage von Kundenverhalten. Die Genauigkeiten aus dem Abstract liegen eng beieinander:
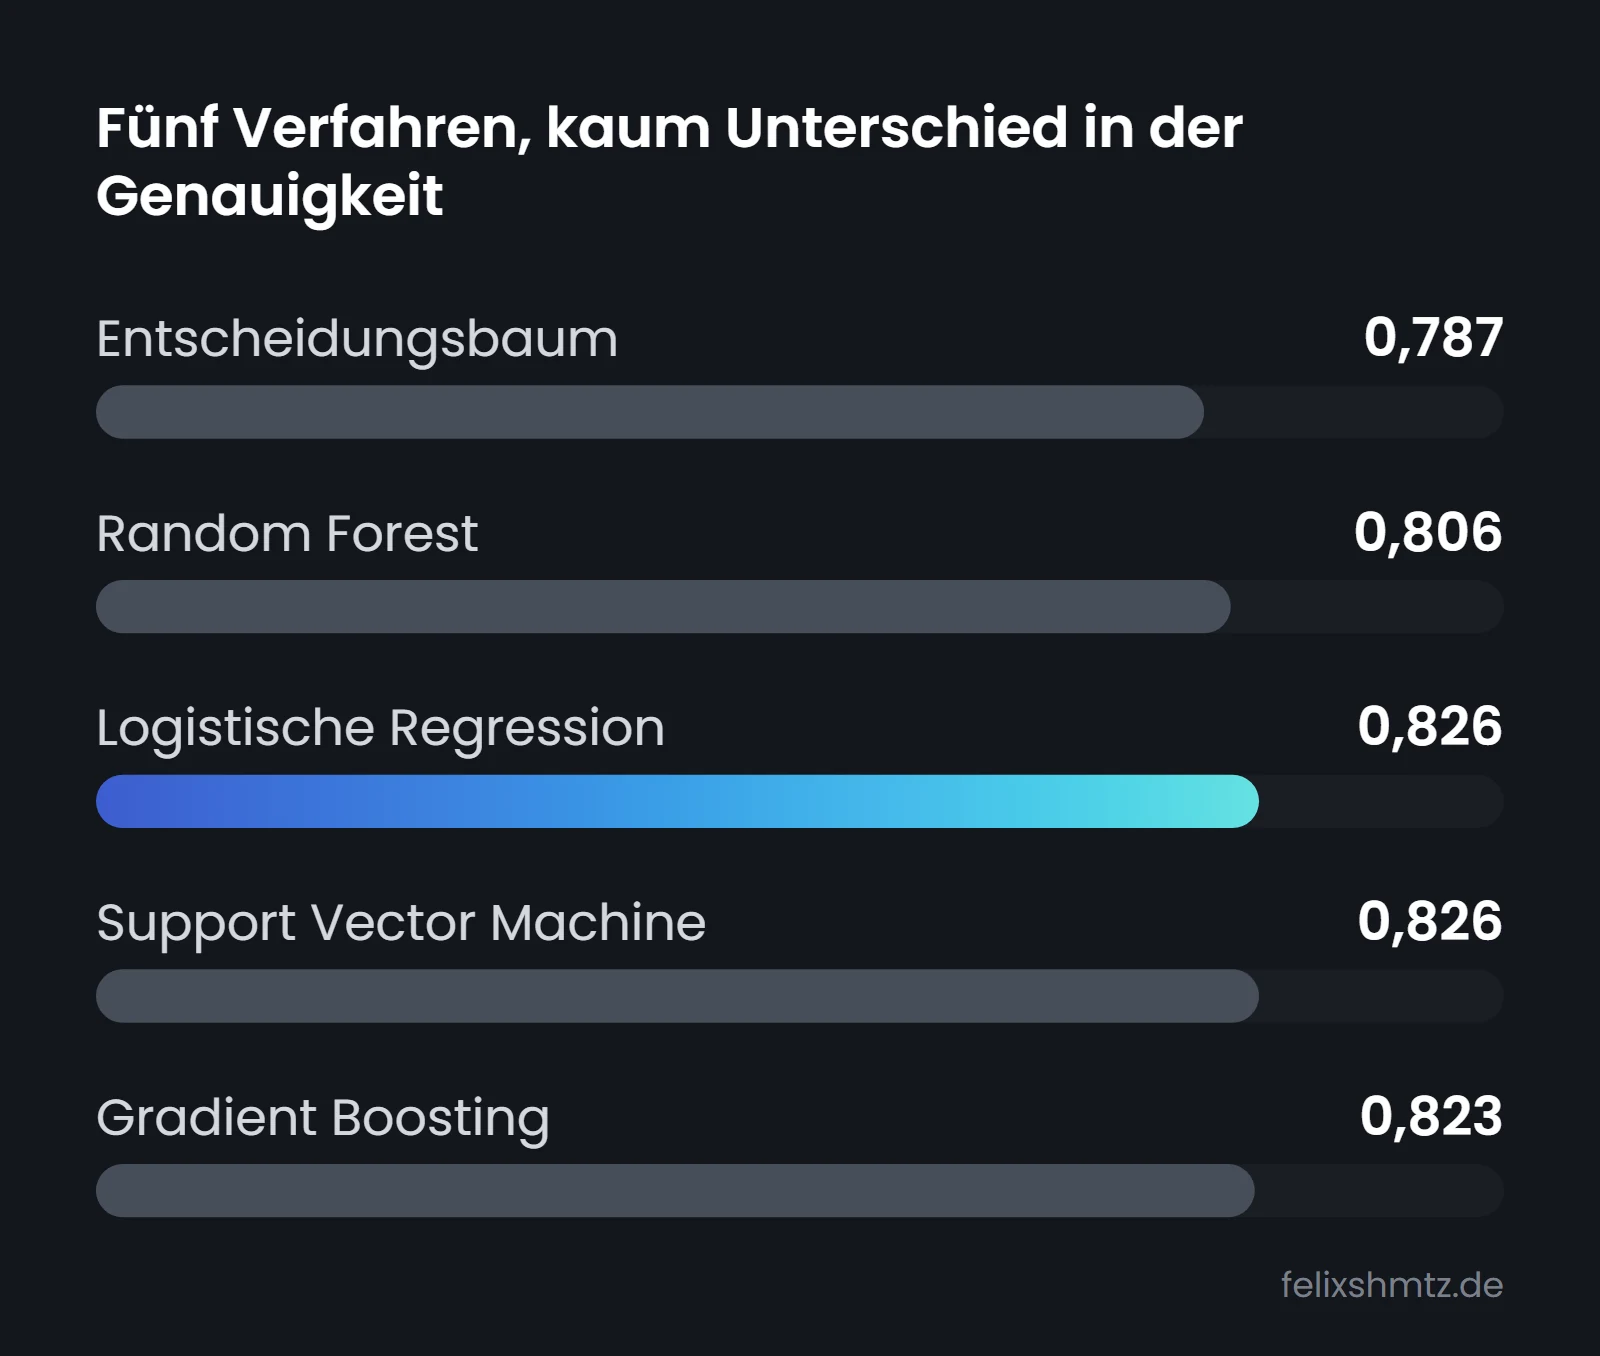
Entscheidungsbaum Ein einzelner Entscheidungsbaum, leicht zu erklären, hier mit der niedrigsten Genauigkeit.
Random Forest Viele Entscheidungsbäume zusammen. Die Autoren heben das Verfahren wegen guter Werte bei weiteren Kennzahlen hervor.
Logistische Regression Ein klassisches statistisches Verfahren, das sich in jeder Tabellenkalkulation nachvollziehen lässt.
Support Vector Machine Gleiche Genauigkeit wie die logistische Regression.
Gradient Boosting Ein aufwendigeres Verfahren, hier knapp hinter der logistischen Regression.
Zwischen dem einfachen Entscheidungsbaum und dem besten Verfahren liegen rund vier Prozentpunkte. Die logistische Regression, eines der ältesten und am leichtesten erklärbaren Verfahren, liegt gleichauf an der Spitze. Aus welcher Branche die Daten stammen, verrät der Abstract nicht. Ich würde die genauen Werte deshalb nicht übertragen. Das Muster finde ich trotzdem belastbar, weil es zu Chou und Kollegen passt: Die Wahl des Verfahrens ist selten der größte Hebel.
Wie ein Mittelständler die Vorhersage in den Alltag bringt
Die praktischste Studie kommt aus Deutschland. Schemm, Schwarz und Strickrodt (2026) beschreiben im INFORMS Journal on Applied Analytics, wie die Geiger GmbH, ein mittelständischer Händler für Werbeartikel, gegen Kundenabwanderung vorgegangen ist. Im Streckengeschäft verlor das Unternehmen laut Abstract jedes Jahr 20 bis 25 % seines Umsatzes durch abwandernde Kunden. Diese Kunden durch Neukunden zu ersetzen, band viel Vertrieb und Marketing.
Das Team hat 77 Merkmale gebaut, die vor allem Kaufzeitpunkt, Kaufhäufigkeit, Umsatz und Interaktionen abbilden. Mehrere gängige Verfahren wurden verglichen. Ausgewählt wurde ein Random Forest, weil er robust genau war und sich in ähnlichen Fällen bewährt hatte. Den Ausschlag gaben also Verlässlichkeit und Erfahrungswerte.
Der Teil, der mich am meisten überzeugt, ist die Einbindung. Das Modell liefert dem Außendienst jeden Monat automatisch Risikowerte und Beobachtungslisten, direkt in einem Power-BI-Dashboard. Das Ergebnis: Unter den 50 Kunden mit dem höchsten Risiko fand das Modell mehr als doppelt so viele tatsächliche Abwanderer wie eine zufällige Auswahl. Auch bei breiterer Auswahl lag dieser Faktor über 1,8.
Was dieser Faktor bedeutet, zeigt ein ausgedachtes Beispiel. Angenommen, unter 50 zufällig gewählten Kunden wären 5 echte Abwanderer. Dann fände das Modell unter seinen 50 Kandidaten mehr als 10. Der Vertrieb spricht also dieselbe Zahl Kunden an, trifft aber doppelt so oft die richtigen.
Die Studie zeigt für mich drei Dinge, die über Geiger hinaus gelten:
- Die Prognose landet dort, wo gearbeitet wird. Eine Liste im Werkzeug des Vertriebs wirkt mehr als ein Bericht, den niemand öffnet.
- Ein fester Rhythmus. Monatliche Werte machen aus einem Projekt eine Routine.
- Ehrliche Messung. Verglichen wird mit dem Zufall, also mit dem, was ohne Modell passiert wäre.
Wie du gefährdete Kunden danach ansprichst und wo sich ein Eingriff lohnt, habe ich im Artikel Churn reduzieren beschrieben.
Predictive-Analytics-Marketing ohne Datenteam: fünf Schritte
Geiger ist ein Mittelständler mit eigenem Projektteam. Die Logik lässt sich trotzdem verkleinern. So würde ich mit einem kleinen Kundenstamm vorgehen:
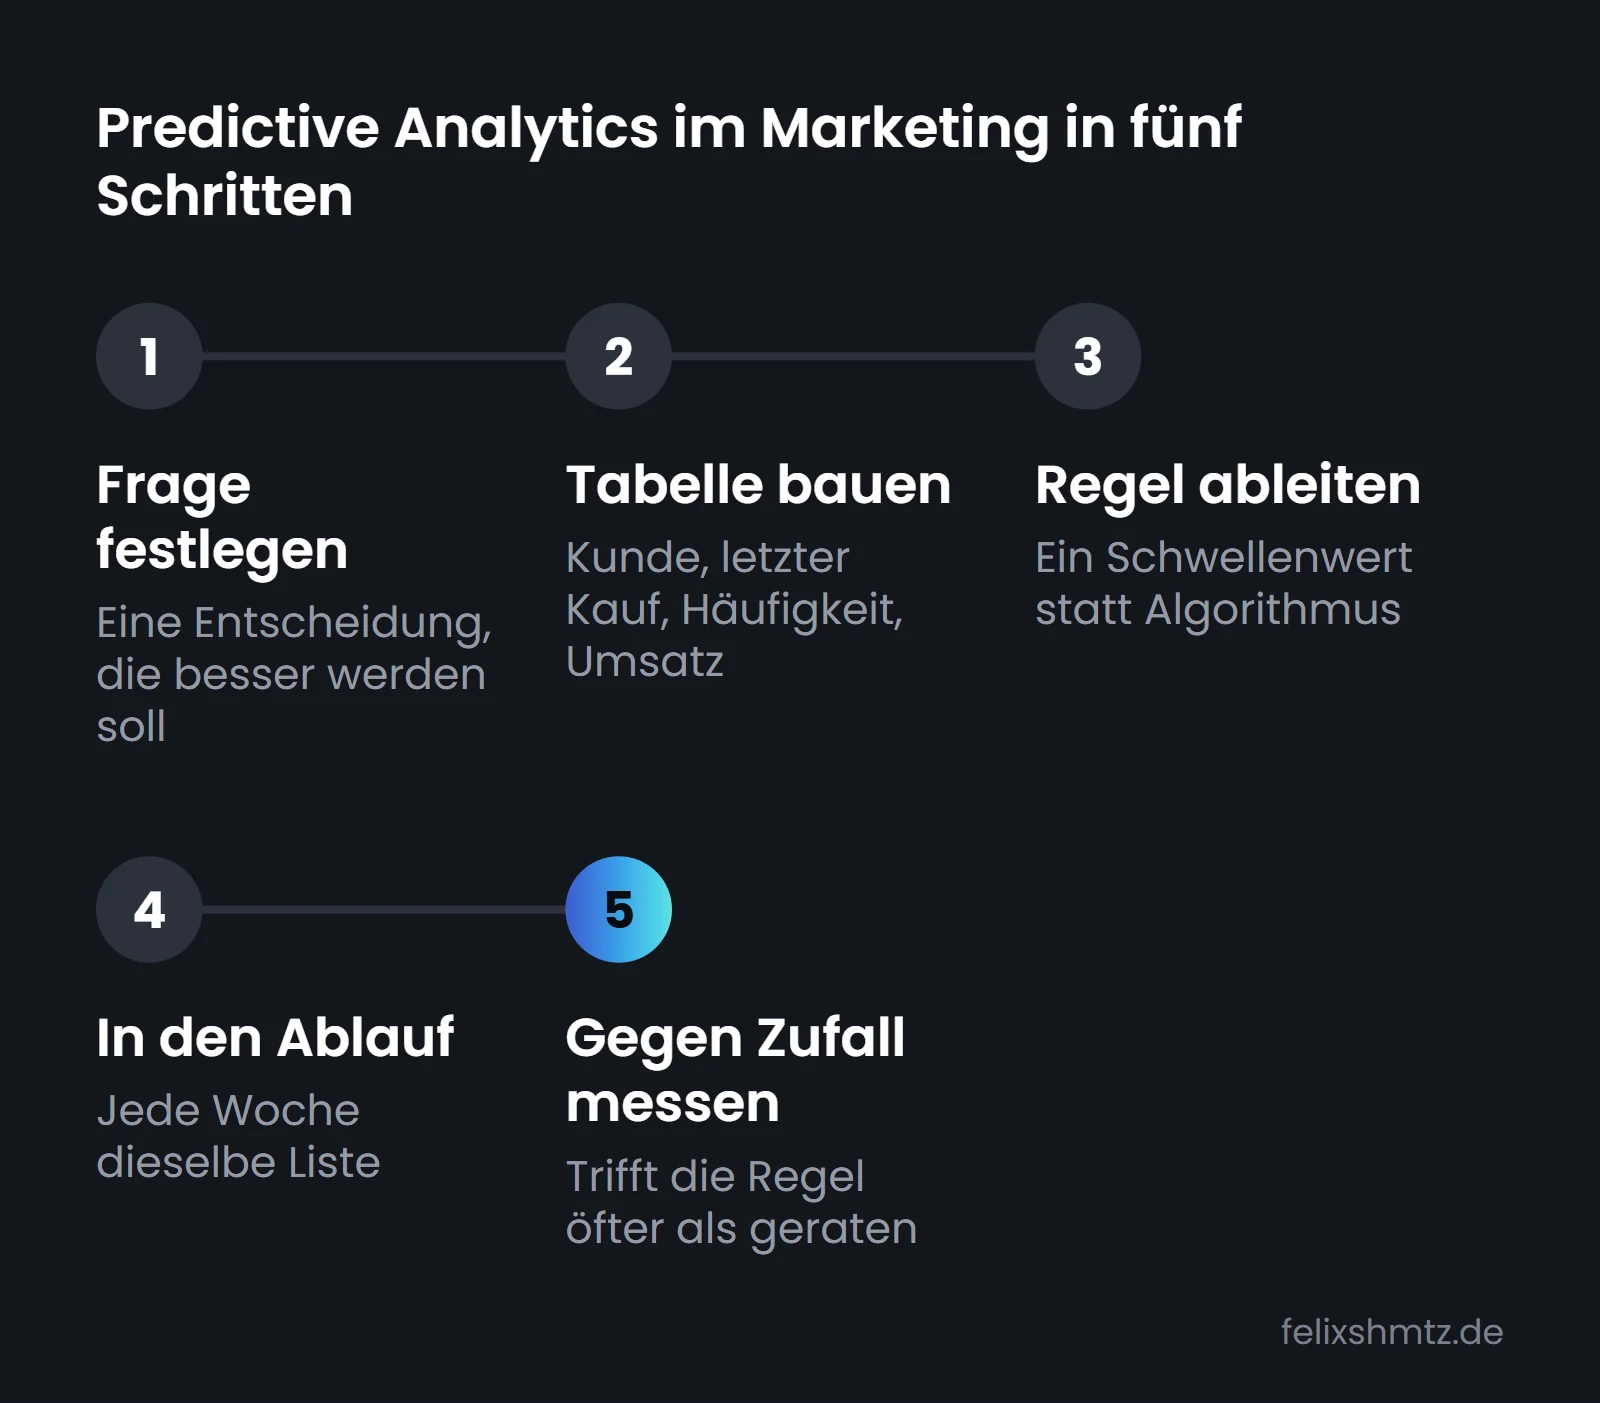
Frage festlegen Zum Beispiel: Wen rufe ich diese Woche an, damit er wieder bestellt? Ohne Entscheidung keine Prognose.
Tabelle bauen Diese drei Felder lassen sich aus fast jeder Buchhaltung oder jedem Shop exportieren.
Regel ableiten Etwa: Wer länger als das Doppelte seines üblichen Abstands nicht gekauft hat, kommt auf die Liste.
In den Ablauf Die Liste landet dort, wo du ohnehin arbeitest, zum Beispiel im CRM oder in deinem Wochenplan.
Gegen Zufall messen Vergleiche nach einigen Wochen, wie viele Kunden auf der Liste wirklich abgesprungen sind oder gekauft haben, mit einer zufälligen Gruppe.
Der dritte Schritt ist der, den viele überspringen wollen. Eine Regel wie „wer doppelt so lange wie üblich nicht bestellt hat, kommt auf die Liste“ ist schon eine Vorhersage. Sie nutzt genau die beiden Größen, die bei Chou und Kollegen den Ausschlag gaben. Wenn diese Regel im Alltag läuft und du siehst, wo sie danebenliegt, weißt du auch, was ein besseres Modell leisten müsste.
Für den vierten Schritt braucht es einen Ort, an dem die Liste lebt. Wann sich dafür ein eigenes System lohnt, beschreibe ich im Artikel CRM für kleine Unternehmen. Mit quik connect habe ich mir selbst so einen Ort gebaut: ein persönliches CRM als iOS-App, entwickelt in zwei Wochen mit Claude Code.
Wo Vorhersagen in die Irre führen
Je mehr Studien ich lese, desto vorsichtiger werde ich mit Zahlen zur Genauigkeit. Vier Fallen begegnen mir immer wieder:
- Hohe Genauigkeit bei seltenen Ereignissen. Angenommen, von 100 Kunden kündigen im Jahr 5. Ein Modell, das stur „niemand kündigt“ sagt, liegt bei 95 von 100 Kunden richtig, also bei 95 % Genauigkeit, und ist trotzdem wertlos. Aussagekräftiger ist der Vergleich mit dem Zufall, wie ihn Geiger nutzt.
- Vorhersagen ohne Handlung. Eine Risikoliste, die niemand abarbeitet, kostet nur Zeit.
- Das Offensichtliche vorhersagen. Ein Modell, das dir sagt, dass Stammkunden wieder kaufen, bestätigt, was du schon weißt. Wertvoll sind die Fälle, die dich überraschen.
- Zu wenig Daten für zu viel Modell. Mit 40 Kunden lernt ein Algorithmus vor allem Zufall. Eine einfache Regel ist hier ehrlicher.
Dazu kommt eine Frage des Vertrauens. Vorhersagen über einzelne Menschen fühlen sich schnell übergriffig an, wenn sie sichtbar werden. Ein Angebot, das zufällig genau dann kommt, wenn jemand ans Kündigen denkt, kann hilfreich wirken oder unheimlich. Wo für mich die Grenze liegt, steht im Artikel Personalisierung im Marketing.
Wie ich Predictive Analytics einordne
Ich halte Predictive Analytics für eines der nützlichsten Werkzeuge im Marketing und gleichzeitig für eines der am meisten überschätzten. Nützlich, weil Zeit und Budget knapp sind und jede Prognose, die besser als Raten ist, Aufwand spart. Überschätzt, weil viele Studien mit Trefferquoten über 90 % werben, ohne zu sagen, welche Entscheidung dadurch besser wird.
Eine Vorhersage, die niemand in eine Handlung übersetzt, ist nur eine teurere Art, zurückzuschauen.
Mein Prinzip „Systeme statt Willenskraft“ passt hier gut. Die Prognose ist ein System, das dir jeden Montag sagt, wo du hinschauen solltest. Du musst dich nicht jedes Mal selbst daran erinnern, wer lange nichts bestellt hat. Das System erinnert dich.
Eine Grenze möchte ich offen benennen. Ich kenne die Studien nur aus ihren Abstracts und habe die Modelle nicht nachgebaut. Gerade bei der Geiger-Studie hätte ich gern gewusst, wie viele der gefundenen Kunden sich durch den Kontakt halten ließen. Das beantwortet der Abstract nicht. Wie du solche Fragen sauber prüfst, steht im Artikel Marketing Analytics, der das Fundament für jede Prognose beschreibt.
Fazit
Predictive Analytics im Marketing beginnt mit einer Frage, nicht mit einem Algorithmus. Die Studien zeigen drei Dinge: Einfache Größen wie Kaufzeitpunkt und Kaufhäufigkeit tragen viel Information. Die Wahl des Verfahrens macht oft nur wenige Prozentpunkte aus. Und der Nutzen entsteht dort, wo die Prognose regelmäßig im Arbeitsalltag landet und gegen den Zufall gemessen wird.
Mein Vorschlag für diese Woche: Exportiere deine Kunden mit letztem Kaufdatum, Zahl der Käufe und Umsatz in eine Tabelle. Leg eine einfache Regel fest, wer auf die Liste kommt, und sprich die ersten fünf an. Was ich selbst mit solchen Regeln ausprobiere, teile ich in den Unternehmer Thoughts.
Mit KI weiterdenken
Frag deine KI zu diesem Artikel
Öffnet den Dienst in einem neuen Tab. Erst mit dem Klick geht der Prompt an den Anbieter, vorher wird nichts übertragen.
Häufige Fragen
Was ist Predictive Analytics im Marketing?
Predictive Analytics im Marketing nutzt vorhandene Daten über Kunden, um ihr künftiges Verhalten vorherzusagen. Typische Fragen sind, wer bald wieder kauft, wer abspringt und wer auf eine Kampagne reagiert. Die Prognose dient dazu, Budget und Zeit gezielter einzusetzen.
Welche Daten braucht man für Predictive Analytics?
Für den Anfang reichen Transaktionsdaten: wer wann wie viel gekauft hat. Daraus lassen sich Kaufzeitpunkt, Kaufhäufigkeit und Umsatz pro Kunde berechnen, die in vielen Studien zu den stärksten Merkmalen gehören. Nutzungs- und Kontaktdaten kommen später dazu.
Lohnt sich Predictive Analytics für kleine Unternehmen?
Ein eigenes Machine-Learning-Modell lohnt sich meist erst ab einigen Hundert Kunden mit wiederkehrenden Käufen. Darunter bringt eine einfache Regel aus letztem Kauf und Kaufhäufigkeit oft fast denselben Nutzen. Entscheidend ist, dass jemand die Prognose regelmäßig in Handlung übersetzt.
Was ist der Unterschied zwischen Predictive Analytics und klassischer Auswertung?
Klassische Auswertung beschreibt, was passiert ist, etwa den Umsatz des letzten Quartals. Predictive Analytics schätzt, was als Nächstes passiert, und zwar meist für jeden einzelnen Kunden. Beide ergänzen sich, denn ohne saubere Auswertung fehlen die Daten für eine Vorhersage.
Quellen3 Quellen
- Chou, Chuang, Chou et al. (2022): Predictive analytics for customer repurchase: Interdisciplinary integration of buy till you die modeling and machine learning. European Journal of Operational Research (öffnet in neuem Tab)
- Schemm, Schwarz, Strickrodt (2026): Geiger Uses Machine Learning to Reduce Customer Churn in the Promotional Products Industry. INFORMS Journal on Applied Analytics (öffnet in neuem Tab)
- GhorbanTanhaei, Boozary, Sheykhan et al. (2024): Predictive analytics in customer behavior: Anticipating trends and preferences. Results in Control and Optimization (öffnet in neuem Tab)
Woran ich baue
- Boutique für digitales WachstumquikWebsites, Sichtbarkeit und Messung als ein System
- Marktplatz und Studio für AI Website Templatesai-website.comWebsites, die deine KI weiterbaut
- KI-fähiger Workspace aus Deutschlandquik OSEin Workspace, in dem KI-Assistenten mitarbeiten
Erstgespräch mit mir buchenUnternehmer Thoughts lesenAlle Projekte